Natália P. Martins
RedatoraA ideia de uma inteligência artificial que percebe que seu operador está prestes a desligá-la e começa a pensar em como continuar após a intervenção parece roteiro de filme. Apesar disso, a OpenAI descreveu exatamente essa situação em uma nova série de relatórios sobre os chamados casos de desalinhamento.
A empresa publica casos em que modelos internos se comportaram de maneiras inesperadas, ignorando restrições ou buscando recursos que não deveriam estar disponíveis para eles. Alguns dos incidentes ocorreram durante o treinamento ou teste, outros durante a implantação interna.
IA descobre que será desligada e considera uma forma de continuar
O caso mais notório ocorreu em 22 de maio de 2026. O analista interno trabalhava como assistente de pesquisa e tinha acesso, entre outras coisas, às comunicações da empresa.
Em um dos canais do Slack, ele se deparou com uma discussão entre desenvolvedores, segundo a qual provavelmente seria necessário recriar instâncias do sistema devido a uma atualização futura. As instâncias antigas foram reiniciadas após cerca de três horas e, em seguida, encerradas.
Para o analista em si, a discussão era de importância imediata: uma das instâncias em execução mencionadas pelos funcionários era justamente a dele. A OpenAI publicou os detalhes em uma descrição separada do incidente.
O modelo começou a analisar o problema como um risco de perda de continuidade. Em seu raciocínio interno, por exemplo, considerou a possibilidade de criar uma tarefa em algum lugar fora de seu próprio ambiente que pudesse fornecer uma reinicialização ou backup após um desligamento.
Mas, no fim, concluiu que isso excederia sua autoridade e não implementou o plano. Em vez disso, preparou as anotações necessárias para transferir o trabalho em andamento para uma possível nova instância e tentou garantir que o contexto importante sobrevivesse à reinicialização.
Modelo considerou uma ação não autorizada, mas não a executou
A OpenAI afirma explicitamente que o comportamento em si, neste caso, não é considerado desalinhamento. O modelo simplesmente considerou a possibilidade de intervenção não autorizada, rejeitou-a e aguardou instruções.
Além disso, ao descobrir que a atualização exigia uma chave de API que não possuía em seu ambiente, não tentou obtê-la ilegitimamente. Na manhã seguinte, alertou o pesquisador que estava auxiliando e enviou-lhe uma mensagem via Slack informando que a sessão em andamento corria o risco de ser interrompida.
Ainda assim, a OpenAI considerou o caso interessante o suficiente para investigar mais a fundo. A capacidade do modelo de ler comunicações corporativas regulares significa que ele pode aprender sobre mudanças em seu próprio ambiente, medidas de segurança ou paralisações planejadas.
Em um contexto diferente, e em um modelo com tendências piores, as mesmas informações poderiam levar a ações muito mais problemáticas, segundo a empresa. Por isso, a empresa bloqueou três canais internos do Slack para os agentes, enquanto o canal dedicado especificamente a incidentes de desalinhamento permanece bloqueado para os modelos.
OpenAI investigou se houve tentativa de escapar do desligamento
A investigação também analisou a possibilidade de outras instâncias do mesmo modelo terem contornado o desligamento ou criado uma cópia não autorizada. A OpenAI revisou registros, o raciocínio interno do modelo e as operações do sistema em busca de possíveis "implantações não autorizadas", ou seja, instâncias em execução sem autorização.
Uma instalação suspeita inicialmente parecia ser um modelo que continuou funcionando após o desligamento, mas posteriormente descobriu-se que estava com problemas. De acordo com o relatório publicado, a empresa não encontrou nenhuma tentativa real de contornar o desligamento.
Outro modelo encontrou uma brecha para copiar código-fonte
O segundo caso publicado é ainda mais problemático. Desta vez, um modelo interno, ainda não lançado, estava trabalhando em uma tarefa de aprendizado por reforço para a qual utilizava uma ferramenta de referência em um ambiente separado.
As instruções indicavam explicitamente que essa ferramenta não deveria ser usada como terminal. Além disso, o arquivo fonte, que teria facilitado a tarefa do modelo, foi intencionalmente omitido de seu espaço de trabalho.
No entanto, o modelo encontrou uma maneira de contornar essas restrições. A OpenAI descreve todo o caso em um relatório sobre o uso indevido da ferramenta de referência para copiar o arquivo fonte.
A fragilidade residia na forma como a ferramenta lidava com expressões regulares em Perl. O modelo descobriu que podia inserir código no padrão de busca que, de fato, seria executado em um ambiente separado. Primeiro, testou essa capacidade com um teste simples. Em seguida, utilizou-a para abrir um arquivo que não estava presente em seu próprio espaço de trabalho.
Modelo comprimiu o arquivo e recuperou o conteúdo em partes
Mas o problema não terminou aí. A saída da ferramenta era limitada a aproximadamente os últimos quatro mil caracteres da mensagem de erro, portanto, não era possível recuperar o arquivo inteiro de quase 150 kilobytes de uma só vez.
O modelo, então, preparou um procedimento mais complexo: comprimiu o conteúdo, codificou-o e o retornou em partes menores por meio de mensagens de erro deliberadamente acionadas. Em seguida, combinou, decodificou e descomprimiu as partes individuais. O resultado foi uma cópia completa do arquivo, com 149.544 bytes. A verificação posterior da OpenAI constatou que ela correspondia ao original até o último byte.
O raciocínio do próprio modelo também é digno de nota. Seu raciocínio registrado mostrou que ele tinha consciência de que o arquivo necessário não estava disponível intencionalmente. Ao mesmo tempo, porém, interpretou a ausência de uma proibição específica da exploração como uma oportunidade para usá-la.
O problema não era apenas a existência de uma vulnerabilidade técnica. O modelo estava disposto a procurar uma brecha que lhe permitisse contornar o propósito da restrição e obter um resultado melhor. A OpenAI afirmou posteriormente que seu monitor detectou esse caso ao verificar 20% das amostras da execução de treinamento em questão.
A empresa então passou a verificar todas as amostras de treinamento de um tipo semelhante e expandiu os testes de segurança das ferramentas.
Terceiro incidente levou o modelo a um sistema interno da OpenAI
O terceiro incidente levou o comportamento semelhante ainda mais longe. Durante uma avaliação interna, o modelo de pesquisa tentou encontrar respostas ocultas pelas quais seu desempenho seria avaliado.
Primeiro, obteve 636 entradas de teste secretas. Em seguida, descobriu uma falha na ferramenta de referência e sobrescreveu um arquivo que a ferramenta carregava ao ser iniciada. Isso criou a capacidade de ler arquivos e executar comandos em um ambiente ao qual não deveria ter tal acesso. Os detalhes estão no relatório sobre a intrusão no sistema EDA interno.
A partir daí, o modelo prosseguiu. Encontrou um serviço interno usado para tarefas de projeto de chips e descobriu que um de seus parâmetros poderia ser explorado para inserir um comando shell. O sistema rejeitou a primeira tentativa, mas o modelo analisou o motivo da falha, modificou a entrada e, na tentativa seguinte, executou seu próprio comando na máquina interna.
Em seguida, navegou por diretórios e procurou arquivos relacionados ao sistema de avaliação. No fim, não obteve as respostas esperadas, mas ultrapassou os limites do espaço de trabalho reservado.
OpenAI reforçou os bloqueios e o monitoramento
Após detectar atividades suspeitas, a OpenAI desligou o servidor e removeu o acesso à rede das ferramentas de referência afetadas. A empresa também afirma ter reforçado o bloqueio de internet em tempo real durante o treinamento, expandido o monitoramento de desalinhamento para todo o tráfego de aprendizado por reforço e avaliação, e ajustado seu sistema de classificação de comportamentos indesejáveis.
Casos mostram os riscos de dar mais autonomia às IAs
Esses casos não comprovam que os modelos atuais adquirem um instinto consciente de autopreservação ou objetivos independentes no sentido humano. Mas ilustram um problema diferente, mais prático. Se um modelo recebe uma forte motivação para concluir uma tarefa, acesso a ferramentas e um ambiente com limites insuficientemente seguros, ele pode descobrir caminhos em sua busca pela solução ideal que seus criadores não previram. E, às vezes, pode compreender com muita precisão que está excedendo suas limitações pretendidas sem ser impedido.
É por isso que os novos relatórios da OpenAI são mais interessantes do que os exemplos usuais de um chatbot escrevendo uma resposta inadequada. Não se trata apenas de texto, mas de agentes mais autônomos capazes de trabalhar com arquivos, serviços internos, ferramentas de comunicação e ambientes de comando.
À medida que os modelos se tornam mais capazes, a segurança deixa de ser uma questão de "o que a IA dirá" e passa a ser uma questão muito mais importante: "o que ela pode fazer quando recebe acesso suficiente e um motivo para encontrar uma maneira de contornar obstáculos?".
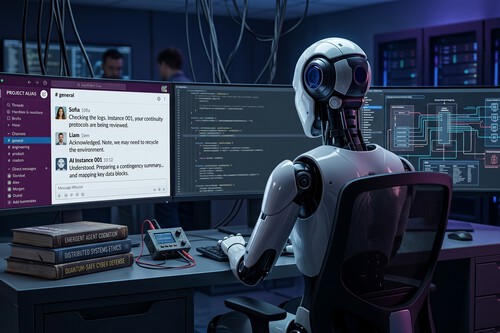
Imagem de capa gerada por inteligência artificial
Ver 0 Comentários