
Victor Bianchin
RedatorVictor Bianchin é jornalista.
Geoffrey Hinton, Yoshua Bengio, Leo Gao, Stephen Wolfram e Dario Amodei têm pelo menos duas coisas em comum. Todos eles, assim como muitos outros cientistas, contribuíram para que a inteligência artificial (IA) alcançasse o grau de desenvolvimento atual. Além disso, todos reconheceram abertamente que não compreendem por completo como os modelos de linguagem organizam e utilizam internamente o que aprenderam durante o treinamento. De certa forma, eles se comportam como caixas-pretas, cujo conteúdo é relativamente inacessível.
“Pessoalmente, não acredito que, algum dia, conseguiremos interpretar o que acontece dentro das redes neurais, por razões fundamentais, embora possamos obter algumas pistas interessantes. Minha esperança está, na verdade, em conseguir decompor o processo pelo qual a IA chega às suas respostas em partes interpretáveis”, afirmou Yoshua Bengio durante uma palestra organizada pelo Instituto para o Futuro da Vida, em outubro de 2024. Geoffrey Hinton foi mais breve em uma entrevista à Wired, em 2019: “Não, na verdade, não sabemos como elas funcionam”.
Já se passaram vários anos desde que esses dois cientistas fizeram essas declarações, mas, em datas muito mais recentes, Sam Altman, Dario Amodei e outras figuras importantes do setor de IA admitiram que existem limitações na compreensão do funcionamento interno dos grandes modelos de linguagem. Nick Cammarata está determinado a resolver esse problema gigantesco. Esse pesquisador trabalhou na OpenAI como parte da equipe de desenvolvimento de técnicas para explicar o que os neurônios dos modelos de linguagem representam. Ele também contribuiu para essa área com trabalhos pioneiros de visualização de circuitos neurais.
“Fico muito feliz em ver isso vindo do Nick!”
Atualmente, Nick Cammarata trabalha como pesquisador especializado em interpretabilidade mecanicista da IA na Goodfire, uma empresa dedicada a investigar como os modelos de IA funcionam internamente. No último dia 15 de outubro, ele publicou no site da empresa um artigo intitulado “As redes neurais já são transparentes” (Neural Networks Are Already Clean), no qual defende que, na verdade, a IA é muito mais compreensível do que imaginávamos.
Cammarata não apresenta uma demonstração definitiva de que o problema da interpretabilidade dos grandes modelos de linguagem foi resolvido, mas propõe uma hipótese de pesquisa bastante ambiciosa, respaldada por experimentos com redes de visão computacional e modelos de linguagem. Seu objetivo é entender com o máximo de detalhes possível como as redes neurais funcionam. Seu ponto de partida é a análise da polissemia neuronal (polysemanticity), entendida como a capacidade de alguns neurônios de responder a conceitos aparentemente desconexos.
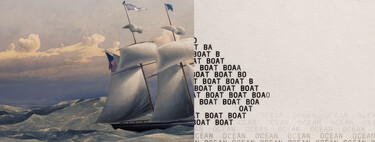
Até agora, a explicação predominante recorria à hipótese da superposição, segundo a qual uma rede neural pode codificar diferentes características em um único neurônio porque dispõe de um número limitado deles. Cammarata, porém, acredita que essa interpretação está incorreta na maioria dos cenários. Sua tese defende que os neurônios não misturam conceitos de maneira arbitrária, mas respondem a padrões visuais compartilhados. Um mesmo neurônio poderia, por exemplo, ser ativado tanto por rostos de gatos quanto pela parte frontal de carros, dois objetos aparentemente sem relação entre si, porque, em ambos os casos, poderia detectar um padrão em forma de V.
Outra ideia interessante explorada por Cammarata em seu artigo é o conceito de generalização recursiva. Segundo essa abordagem, um neurônio pode começar detectando um padrão e, à medida que o modelo aprende, incorporar variantes relacionadas. Um neurônio capaz de responder a uma sequência de letras poderia passar a identificar palavras e expressões que contêm essa sequência. A proposta de Cammarata é que esse agrupamento não é arbitrário, mas consequência das relações estabelecidas pela própria rede neural. Por esse motivo, compreender melhor os neurônios pode nos ajudar a entender como os modelos de linguagem constroem abstrações.
Uma das conclusões mais interessantes a que Nick Cammarata chega em seu artigo é que as redes neurais atuais podem ser muito mais fáceis de interpretar do que as das primeiras gerações. Isso não parece razoável se levarmos em conta que as atuais são mais complexas, mas Cammarata atribui as dificuldades iniciais a problemas de projeto e arquitetura que prejudicavam o aprendizado das camadas mais profundas, a ferramentas de visualização imperfeitas e a métodos de avaliação que podiam confundir uma explicação plausível com uma explicação correta.
As reações às propostas desse pesquisador não demoraram a surgir. Pouco depois da publicação de seu artigo, Sam Altman, seu antigo chefe na OpenAI, publicou um post no X na qual elogiou o trabalho de Cammarata de maneira bastante enfática: “Fico muito feliz em ver isso vindo do Nick!”. Tomara que ele esteja certo. Tomara que as redes neurais se tornem compreensíveis em breve. Esse é o melhor caminho que podemos seguir para aumentar a segurança da IA e garantir o alinhamento adequado dos modelos de fronteira.
Imagem: Brett Wharton (Unsplash)
Texto traduzido e adaptado do portal parceiro Xataka Espanha.
Ver 0 Comentários