
Victor Bianchin
RedatorVictor Bianchin é jornalista.
O fato de estarmos cercados por textos escritos por uma IA já não surpreende ninguém. Nós, que queremos ler textos escritos por pessoas, passamos o dia inteiro com o radar ligado, procurando indícios para verificar se estamos lendo algo escrito por um humano ou por um robô. Mas, para além da questão da preferência, há áreas como a educação em que são necessárias boas ferramentas para detectar textos escritos por IA.
Só que muitas das ferramentas disponíveis ainda são bastante falhas, classificando textos humanos como “feitos por IA” e vice-versa. Um pesquisador chamado Jochen Madler se cansou disso e idealizou um sistema que não apenas diz se um texto foi escrito por IA ou não, mas também se foi escrito por um humano que simplesmente se dedicou a parafrasear o resultado fornecido pela IA. Segundo ele, a taxa de acertos fica próxima de 98%.
O estudo se intitula “SlopShape” e, nele, Madler explica que o sistema analisou uma série de textos que o modelo nunca havia visto e alcançou os já mencionados 98% de sucesso ao classificar se haviam sido escritos por uma IA ou por um humano do início ao fim.
Segundo o pesquisador, o sistema não lê o texto e emite um veredito. Em vez disso, um modelo de linguagem responde a um questionário com mais de 200 perguntas sobre a estrutura de cada publicação. Especificamente, analisa a ordem em que as ideias são apresentadas, se o artigo antecipa sua estrutura, observa onde a tese aparece, como as fontes são apresentadas, a orientação prática do artigo e se o texto termina repetindo ou reformulando a conclusão.
O experimento
Para colocar seu sistema à prova, Madler reuniu 2.250 posts de blogs de 268 empresas de comunicação, todos publicados antes do lançamento do ChatGPT e recuperados usando a Wayback Machine. Em seguida, pediu a cinco modelos (GPT-5.4, Claude Sonnet 4.6, Gemini 3 Flash, DeepSeek V3.2 e Kimi K2.5) que escrevessem sua própria versão a partir de um resumo do conteúdo original.
No total, foram 11.250 versões geradas por esses modelos, escritas e reescritas novamente, para verificar até que ponto seu sistema conseguia identificar mudanças, das mais profundas às menores. O resultado foi que, nos testes, obteve cerca de 97-98 de “macro F1”, uma métrica que combina precisão e cobertura para humanos e IA.
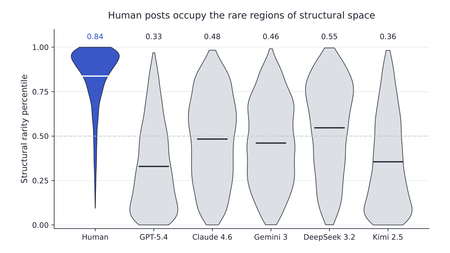 Imagem: Jochen Madler
Quando os textos eram reescritos várias vezes usando a IA, esse macro F1 variava muito pouco. Só caiu significativamente quando características de estilo eram alteradas (com uma pontuação de 88,1). A conclusão é que a IA deixa uma marca na arquitetura do discurso, produzindo textos previsíveis, muito mastigados e com conclusões repetitivas. De fato, segundo os testes, em 79% das ocasiões o sistema conseguia até mesmo apontar qual modelo havia escrito cada texto com base nos “trejeitos” de cada um deles.
A forma do slop
E aqui está o ponto central: o que dá pistas à ferramenta é o que dá título à pesquisa, algo chamado de “forma do slop”. Segundo Madler, ela costuma ter estas características:
- Forma muito ordenada, às vezes com bullet points iniciais que indicam as seções.
- O título promete exatamente o que o artigo vai entregar, sem acrescentar contexto tangencial.
- A introdução apresenta imediatamente a tese e depois segue uma estrutura de “definição, vantagens, etapas, erros e recomendações”, como se fosse um guia ou especialista.
- A conclusão termina parafraseando a ideia que já havia sido anunciada na introdução.
Há outros fatores, como afirmações sem fontes, estatísticas sem contexto ou uma espécie de listas de prós e contras que são sempre equilibradas e não acrescentam nada.
No entanto, o fato de essas características serem cumpridas não demonstra sempre que um texto tenha sido escrito por uma IA. Na verdade, na imprensa e antes do ChatGPT, encontramos agências de comunicação que divulgavam mensagens seguindo essa estrutura tão corporativa. Isso faz sentido porque são os textos que foram usados no estudo e também aqueles com os quais as IAs das diferentes empresas foram treinadas (entre tantas e tantas coisas roubadas para esse treinamento, é claro).
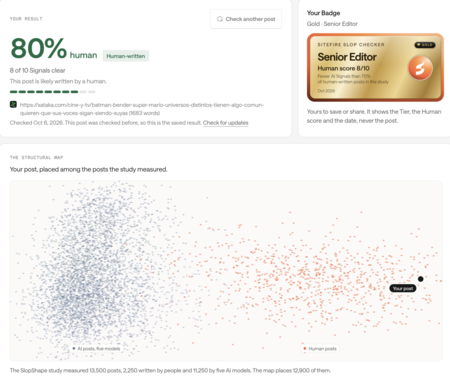 O fato de uma entrevista apresentada de forma mais narrativa ter essa pontuação não pega bem para a ferramenta
Além disso, o estudo foi feito com artigos em inglês, portanto não pode ser aplicado a outros idiomas nem a qualquer texto escrito na Internet. A conclusão é que o que caracteriza as formações é a combinação repetida desses fatores e, sobretudo, os textos excessivamente longos que não apenas não acrescentam nada, mas também não apresentam uma progressão de ideias.
Por enquanto, o trabalho de Madler é apenas mais uma pesquisa sobre algo que, evidentemente, é um problema. Em uma era na qual, a cada dois segundos, são lançados mais e mais modelos de fronteira, são necessárias ferramentas para distinguir quem fez cada texto.
Imagens | Jochen Madler
Este texto foi traduzido/adaptado do site Xataka Espanha.
Ver 0 Comentários